Нейросеть, которая не пишет тексты, а принимает решения
Когда владелец бизнеса приходит ко мне с автоматизацией, он почти всегда описывает задачу как разговор. «Пусть бот общается с клиентом», «пусть нейросеть отвечает на вопросы». А когда я разбираю процесс по шагам, выясняется, что разговора там на один шаг из десяти. Всё остальное это решения.
Заявка пришла: кому её отдать. Письмо от клиента: это срочно или подождёт до завтра. Документ упал в папку: это счёт, акт или договор. Сообщение в чате: человек спрашивает про цену, жалуется или просто здоровается.
Каждое такое решение занимает у человека две секунды и не требует никакого творчества. Но их сотни в день, и именно они съедают время менеджера. А когда такое решение отдают обычной нейросети, происходит странное: машину, которая умеет писать поэмы, просят ответить одним словом. Она пишет это слово медленно и берёт за него деньги как за поэму.
В сентябре 2026 года появилась технология, которая решает ровно эту проблему. Разбираю, что она меняет для обычной компании, где её стоит попробовать первой и где я бы не стал её ставить.
Что это за класс моделей и чем он отличается
15 сентября 2026 года компания TypeSafe представила модель Jev. Сами они называют её первой публичной моделью класса System One, по аналогии с быстрым мышлением человека: тем, которое работает без рассуждений вслух.
Разница с привычной нейросетью простая. Обычная модель порождает ответ по кусочку, и каждый следующий кусочек зависит от предыдущих. Поэтому она и пишет связный текст, и поэтому же она медленная: чтобы получить одно слово, ей нужно пройти весь путь генерации.
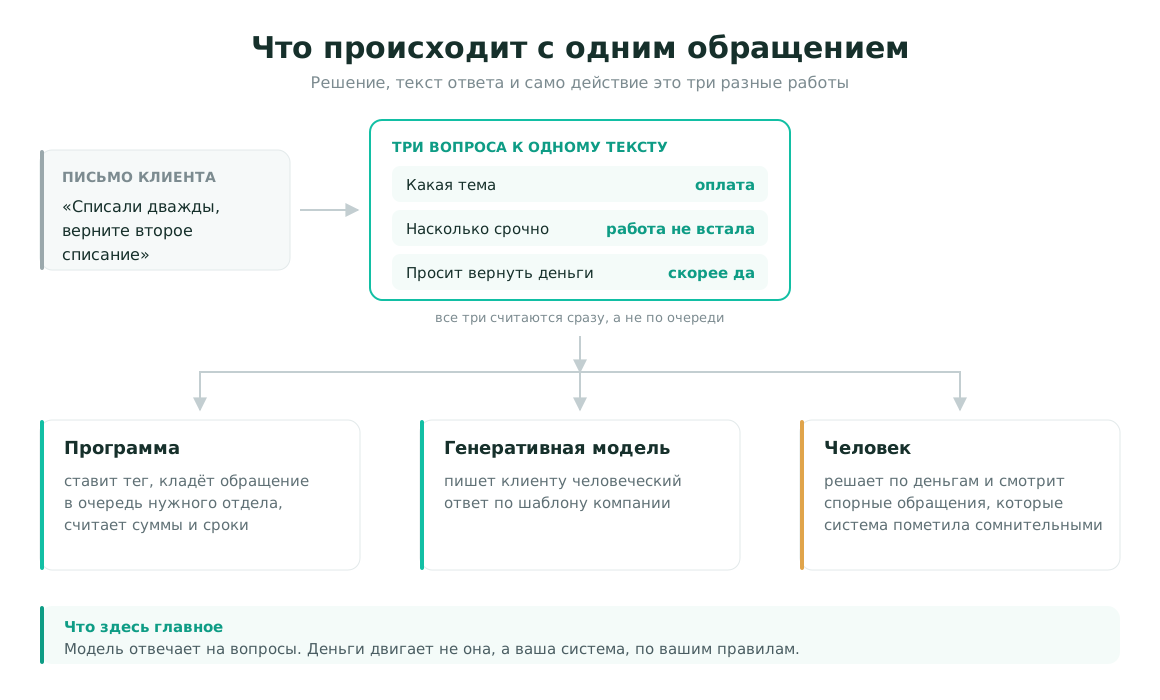
Модель решений устроена иначе. Она получает описание ситуации и возвращает не текст, а ответ в том виде, который программа сразу понимает: выбранный вариант, оценку по шкале, вероятность. Причём несколько таких ответов она считает одновременно, а не по очереди.
Для бизнеса это значит вот что. Раньше ставить машину на каждое мелкое событие было расточительно: дорого по деньгам и заметно по задержке. Теперь такую развилку можно закрывать хоть на каждом входящем письме.
Три вопроса, которые можно задать машине
Модель принимает вопросы трёх видов. Объясню на обращении в поддержку, потому что это самый понятный пример.
Выбор из списка. Вы заранее описываете варианты: оплата, техническая проблема, продажи, непонятно. Модель возвращает один из них и заодно показывает, насколько уверенно она его выбрала. Вариант «непонятно» стоит добавлять всегда: должно быть место, куда деть сообщения, из которых ничего не ясно.
Оценка по шкале. Вы описываете уровни словами: работа клиента идёт как обычно, есть проблема но есть обходной путь, работа остановлена. Модель ставит обращение на эту шкалу. Важно помнить, что получится именно место на вашей линейке, а не деньги и не часы простоя.
Проверка одного признака. Скажем, требует ли человек возврат денег прямым текстом. В ответ приходит не «да» и не «нет», а число от нуля до единицы. И это полезнее, чем кажется: пограничные случаи видно сразу, и именно их имеет смысл показать человеку.
Главное в этих трёх пунктах не технология, а дисциплина. Вам придётся словами описать, что означает каждый вариант ответа. Красивое название поля инструкцию не заменяет. И вот это упражнение само по себе полезно: обычно, когда я прошу владельца описать критерии срочности, выясняется, что в компании их нет, а есть привычка конкретного менеджера.
Где это снимает ручную работу в обычной компании
Теперь к тому, ради чего всё затевалось. Вот задачи, которые я вижу у клиентов чаще всего и в которых такой подход работает.
Разбор входящих заявок. Сообщения приходят в почту, в мессенджеры, с форм на сайте. Кто-то читает их и раскладывает: этому менеджеру, этому, а это спам. Здесь три вопроса закрывают почти всю работу: тема, срочность, есть ли явный запрос на счёт или возврат.
Первая линия поддержки. Не «бот отвечает клиенту», а более скромная и более надёжная вещь: система понимает, к какой теме относится вопрос, насколько он горит, и нужен ли тут живой человек. Ответ клиенту при этом может писать обычная генеративная модель или сам оператор. Решение и текст это разные задачи, и их полезно разделять.
Входящие документы. В компанию падают счета, акты, накладные. Прежде чем что-то с ними делать, надо понять, что это за документ и к какой сделке он относится. Классическая задача на решение, а не на генерацию.
Очередь контента. Если вы ведёте канал или рассылку, у вас есть поток новостей, из которого надо выбрать нужное. Критерии обычно есть в голове: полезно ли это моей аудитории, есть ли тут конкретное действие, не реклама ли это. Их можно записать и применять к каждой новости.
Подбор по складу или каталогу. Когда у товара есть характеристики, а клиент пишет человеческим языком, между ними нужен слой, который переводит одно в другое. Здесь тоже решение, а не текст.
Общее у всех пяти пунктов одно: решение повторяется десятки раз в день, вариантов ответа немного, и ошибку можно заметить. Если у вашей задачи есть эти три признака, она кандидат. Если нет, начинать стоит с другой.
Чего эта технология не делает
Теперь то, о чём в рекламе обычно молчат, а разбираться приходится уже на внедрении.
Гарантия формата не равна правильному решению. Если вы разрешили модели выбирать только из четырёх команд, она вернёт одну из четырёх. Это приятно для программиста: ответ не сломает систему. Но вернуть она может не ту команду. Формат гарантирован, смысл нет.
Я специально останавливаюсь на этом, потому что в анонсах таких моделей обычно пишут «не выдумывает». Читать это надо буквально: не выдумывает вариантов за пределами вашего списка. О том, правильно ли выбран вариант внутри списка, фраза не говорит ничего.
Уверенность модели это не процент правильности. У ответа есть числа, и их легко прочитать неверно. Если система ставит событиям вероятность около 0,8, это значит, что на большом наборе таких событий примерно восемь из десяти сбудутся. Но конкретный ответ с числом 0,8 всё равно может быть ошибкой. Числа полезны, чтобы отобрать сомнительные случаи для человека, а не чтобы отчитаться «точность 80 процентов».
Считать модель не должна. Ни суммы, ни сроки, ни остатки. Это работа обычного кода и формул. Модель добавляет к строке смысл, арифметику делает программа. Смешивать эти две вещи в одном запросе значит получить красивую ошибку, которую трудно заметить.
Где я бы не стал ставить это первым
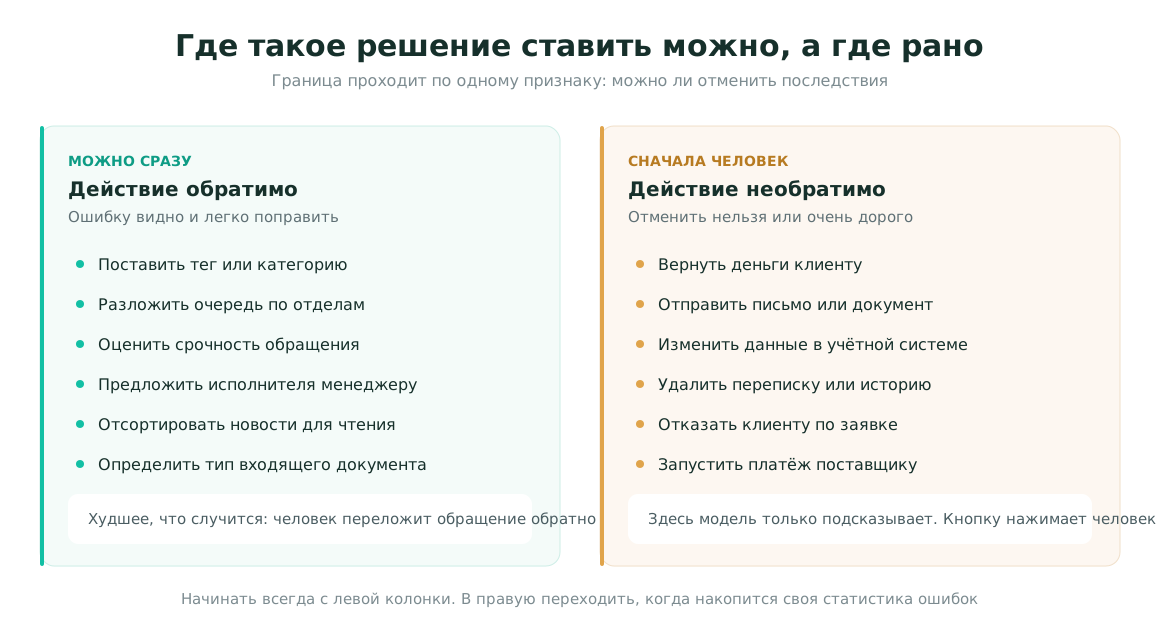
Есть места, куда такую модель ставить рано, даже если технически можно.
Необратимые действия. Всё, что двигает деньги, отправляет документы клиенту или меняет данные в учётной системе. Решение может быть подсказкой человеку, но не последним шагом. Кнопку нажимает человек, пока у вас не накопится своя статистика ошибок.
Единственный экземпляр чего-то важного. Если система чистит историю переписки или сокращает контекст, и копии нет, вы однажды потеряете нужное и не узнаете об этом.
Задачи, где нет критериев. Если вы сами не можете словами объяснить, почему одна заявка срочная, а другая нет, модель это не придумает за вас. Сначала критерии, потом автоматизация. Иначе вы автоматизируете собственную путаницу и получите её же, только быстрее.
С чего начать, чтобы проверить за день
Мой стандартный подход к любой новой технологии такой: маленький проверяемый эксперимент до того, как что-то встраивать.
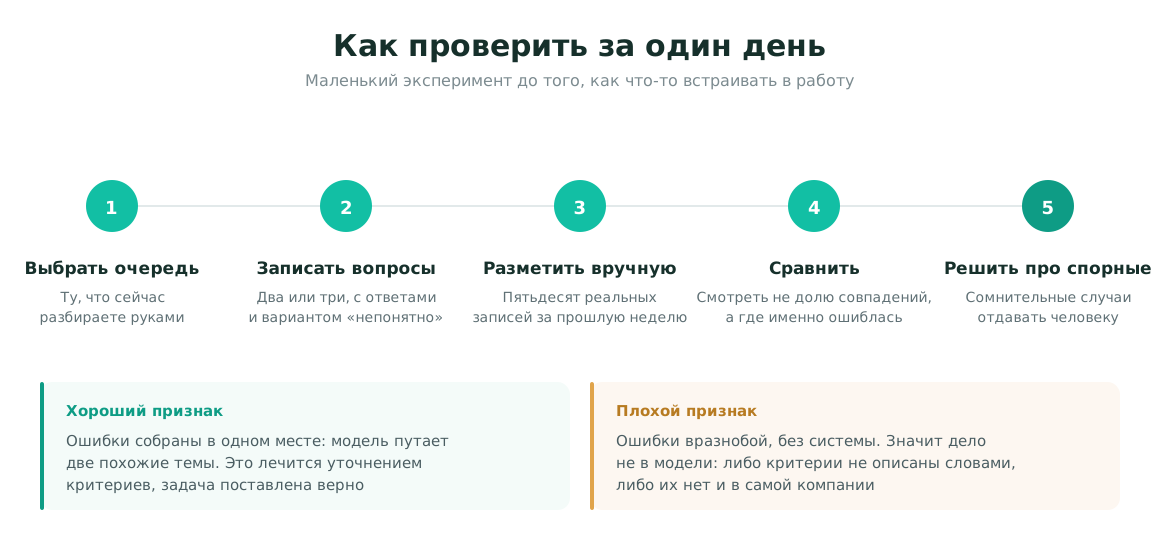
Шаг первый. Возьмите одну очередь, которую сейчас разбираете руками. Заявки, письма, документы, новости. Выберите ту, где больше всего однотипных решений.
Шаг второй. Выпишите два или три вопроса к каждому элементу очереди и допустимые ответы. Обязательно добавьте вариант «непонятно».
Шаг третий. Возьмите пятьдесят реальных записей за прошлую неделю. Разметьте их сами или руками менеджера, который обычно этим занимается. Это ваш эталон.
Шаг четвёртый. Прогоните те же записи через модель и сравните с эталоном. Смотрите не на общую долю совпадений, а на то, где именно она ошиблась. Ошибки в одну сторону лечатся уточнением критериев. Ошибки вразнобой означают, что задача сформулирована не так.
Шаг пятый. Решите, что делать с сомнительными случаями. Мой ответ обычно один: отправлять человеку. Система, которая честно говорит «я не уверена», полезнее той, которая уверенно ошибается.
На такой эксперимент уходит день работы, и он даёт ответ, которого не даст ни один обзор технологии.
Как понять, что это принесло пользу
Полезный итог звучит конкретно и измеряется в вашей работе, а не в характеристиках модели.
Не «система стала умнее», а «очередь из двухсот обращений разбирается без менеджера, спорных остаётся около двадцати, и их смотрит человек». Не «быстрее отвечаем», а «ночные заявки утром лежат уже разобранными по темам».
Три вещи, которые стоит замерить до и после: сколько времени уходит на ручной разбор, сколько заявок дожидается ответа дольше обычного, и сколько раз в неделю что-то уехало не туда. Если после внедрения первые два числа упали, а третье не выросло, технология сработала.
И ещё одно, из опыта: сохраняйте версию модели, формулировки вопросов и исходные ответы. Модели обновляются, поведение меняется, и через месяц вам понадобится повторить тот же опыт, чтобы понять, стало лучше или хуже.
Что со всем этим делать владельцу
Короткий вывод такой. Появился инструмент для той части автоматизации, которая раньше делалась либо руками, либо неоправданно дорого. Он не заменяет ни генеративные модели, ни обычный код, он встаёт между ними и закрывает развилки.
Если у вас в компании есть очередь, которую человек разбирает глазами по понятным правилам, у вас есть кандидат на такую автоматизацию. Если такой очереди нет, эта технология вам пока не нужна, и это нормальный ответ.
Разбираю задачи клиентов именно в таком порядке: сначала нахожу, где решение повторяется каждый день, потом смотрю, можно ли записать критерии словами, и только потом выбираю инструмент. Технология меняется каждые полгода, а порядок работы остаётся.
Если хотите понять, есть ли в вашем процессе такая очередь, напишите мне. Разберу вашу ситуацию и скажу, что стоит автоматизировать в первую очередь, а что лучше не трогать.